
Кодировка YML/XML-фида: UTF-8, Windows-1251, BOM и кракозябры — как проверить и исправить
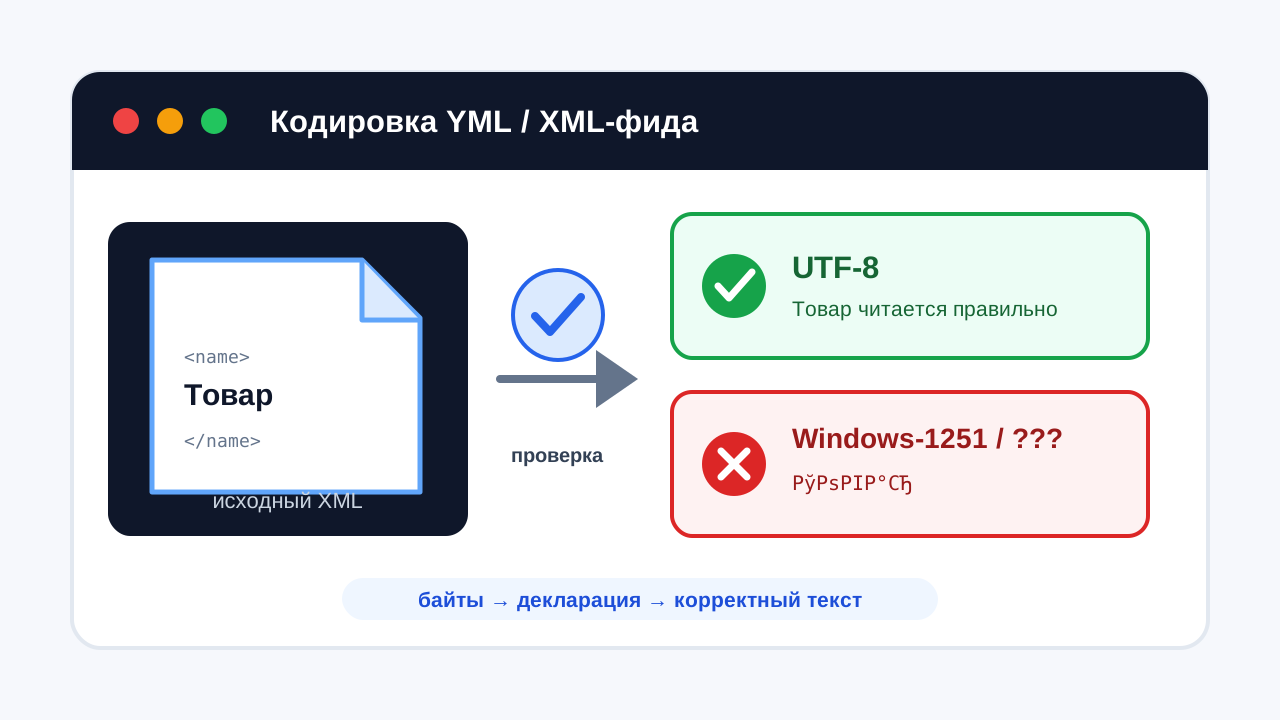
Фид открывается, XML на первый взгляд выглядит нормально, но площадка пишет об ошибке кодировки. Или вместо названий товаров появляются строки вроде Название товара. Обычно причина находится в одном из трёх мест: файл сохранён не в той кодировке, XML-декларация не соответствует содержимому или генератор записал повреждённые байты только для части товаров.
Исправлять это заменой слова UTF-8 в первой строке опасно. Сначала нужно понять, какие байты реально лежат в файле и на каком участке цепочки они изменились.
1. Как выглядит проблема с кодировкой
Самый заметный симптом — русский текст превратился в набор символов, хотя теги остались на месте. Но ошибка может проявляться и иначе:
- парсер сообщает
Invalid byte sequenceилиInput is not proper UTF-8; - обработка останавливается с общим сообщением
parser errorна названии или описании товара; - возникает
XML declaration allowed only at the start of the document; - в декларации указан UTF-8, а файл физически записан в Windows-1251;
- тысячи товаров читаются нормально, но один
offerс повреждённой строкой останавливает импорт всего документа.
Строка и колонка из сообщения парсера — место, где он больше не смог продолжать чтение, а не обязательно источник дефекта. Если ошибка появилась на кириллице, посмотрите исходные байты этой строки и данные товара до генерации XML.
Не каждая ошибка XML связана с кодировкой. Незакрытый тег, сырой амперсанд и неправильная вложенность дают похожий parser error. Порядок диагностики таких случаев разобран в статье «YML/XML-фид не проходит проверку: как найти и исправить ошибки XML».
2. Что означает encoding в начале XML
Обычная декларация выглядит так:
<?xml version="1.0" encoding="UTF-8"?>encoding сообщает XML-парсеру, как интерпретировать байты документа. Это описание содержимого, а не команда на преобразование. Если в декларации написано UTF-8, весь файл должен быть корректной последовательностью UTF-8.
Проблемный сценарий:
<?xml version="1.0" encoding="UTF-8"?>
<name>Товар из файла Windows-1251</name>
На экране редактора этот фрагмент может выглядеть нормально: редактор угадал Windows-1251 и показал буквы. Но парсер следует декларации и встречает байты, недопустимые для UTF-8. Замена UTF-8 на windows-1251 поможет только тогда, когда получатель поддерживает эту кодировку и весь файл действительно записан в ней. В обычном случае надёжнее преобразовать содержимое в UTF-8 и оставить соответствующую декларацию.
3. UTF-8 и Windows-1251
UTF-8 умеет представлять кириллицу, латиницу, знаки валют, типографские кавычки и символы других языков в одном документе. Windows-1251 — однобайтовая кодировка, рассчитанная прежде всего на кириллицу и распространённая в старых Windows-программах, CSV-выгрузках и унаследованных интеграциях.
Для нового YML/XML-фида разумный базовый выбор — UTF-8, если документация конкретной площадки не требует другого. Он уменьшает число преобразований между базой, приложением и файлом. Старую систему не стоит переключать одним флагом: сначала проверьте кодировку соединения с базой, исходных данных, шаблона, ответа сервера и тестовой выгрузки.
4. Почему появляются кракозябры
Нормальное значение:
Название товараПосле неверного декодирования оно может выглядеть так:
Название товараБайты были записаны одним способом, а прочитаны другим. Например, UTF-8-строку ошибочно приняли за Windows-1251, получили кракозябры, а затем сохранили результат обратно в UTF-8. После такого двойного преобразования одной смены настройки отображения уже недостаточно: повреждённые символы стали обычным текстом в новом файле.
Полезный вопрос при диагностике: кракозябры находятся только на экране или уже записаны в исходных данных? Скачайте HTTP-ответ без преобразований и сравните его с записью из базы или API. Если в исходнике текст нормальный, ошибка появляется при генерации или отдаче файла. Если он уже испорчен в базе, конвертация готового XML замаскирует причину и может повредить остальные строки.
5. Что такое BOM
UTF-8 BOM — три служебных байта EF BB BF в начале файла. Они могут помочь некоторым программам распознать кодировку. Само наличие UTF-8 BOM не делает XML невалидным: XML-парсер может корректно его обработать.
Проблема возникает на стыке инструментов. Генератор добавил BOM, затем другой скрипт дописал файл к уже открытому потоку; PHP-файл с BOM отправил эти байты до заголовков; промежуточный обработчик воспринял BOM как обычный текст. В результате сервис видит содержимое до декларации или сообщает, что декларация находится не в начале документа.
Не удаляйте BOM автоматически из всех файлов. Сначала проверьте первые байты и воспроизведите ошибку тем же способом, которым фид получает площадка. Если конкретный сервис или ваша цепочка обработки не справляется с BOM, сохраняйте UTF-8 без BOM и закрепите это в генераторе.
6. XML-декларация должна быть в начале документа
До декларации не должно быть пробела, пустой строки, предупреждения или другого вывода:
<?xml version="1.0" encoding="UTF-8"?>
<yml_catalog date="2026-09-18 10:00">...</yml_catalog>
В PHP перед XML часто случайно попадает warning, отладочный echo, пробел вне <?php или BOM подключаемого PHP-файла. Иногда локальный файл начинается правильно, но веб-сервер добавляет HTML-страницу ошибки, поэтому проверять нужно именно скачанный HTTP-ответ.
Диагностические сообщения отправляйте в журнал, а XML формируйте в отдельном потоке. Для PHP-файлов, содержащих только код, закрывающий ?> обычно не нужен: так меньше шанс случайно вывести пробел после него.
7. Как проверить кодировку YML-фида
Если кодировка неизвестна, начните с реального файла по URL. Основной анализатор ФидСторожа скачает ту же версию, которую видит внешняя площадка, проверит XML и покажет ошибку некорректной кодировки в общем отчёте.
Локально в Linux можно начать с утилиты file:
file feed.xml
file -i feed.xml
Это эвристика, а не доказательство: короткий ASCII-фрагмент одинаково читается в нескольких кодировках, а Windows-1251 может быть определена неточно. Сопоставьте результат с декларацией, HTTP-заголовком Content-Type и тем, как файл создал генератор.
Проверить, что все байты допустимы для UTF-8, можно без изменения файла:
iconv -f UTF-8 -t UTF-8 feed.xml > /dev/nullЕсли iconv сообщает illegal input sequence, файл не является целиком корректным UTF-8. Посмотреть первые байты и BOM удобно так:
xxd -l 16 feed.xmlНачало ef bb bf означает UTF-8 BOM. Если файл подтверждённо записан в Windows-1251, преобразование в отдельный файл выполняется так:
cp feed.xml feed.xml.bak
iconv -f WINDOWS-1251 -t UTF-8 feed.xml > feed-utf8.xml
Не конвертируйте вслепую. Сначала определите исходную кодировку и сохраните резервную копию. Повторное преобразование уже корректного UTF-8 — один из самых быстрых способов получить кракозябры.
8. Как исправить файл: четыре сценария
Декларация неправильная, файл фактически UTF-8
Если проверка подтверждает корректный UTF-8, а в первой строке указана другая кодировка, исправьте генератор декларации на encoding="UTF-8". Не перекодируйте содержимое: оно уже правильное. После изменения скачайте файл заново, чтобы исключить старую копию из кэша.
Файл действительно Windows-1251
Определите границу, на которой данные всё ещё Windows-1251, и преобразуйте их один раз в UTF-8. Для разового файла подойдёт iconv; для постоянного фида исправьте генератор. Затем укажите UTF-8 в декларации, проверьте HTTP-заголовок и прогоните результат через XML-парсер. Простая правка декларации байты не меняет.
Один источник отдаёт повреждённую строку
Если ошибка появляется только на отдельных товарах, найдите общее поле или поставщика. Сохраните сырое значение до шаблона и проверьте его отдельно. Не перекодируйте весь документ из-за одного описания: нормальные строки могут испортиться. Лучше зафиксировать кодировку на входе этого источника, отклонить некорректное значение и записать ID товара в лог.
До декларации попадает лишний вывод
Скачайте ответ через curl или сохраните тело запроса в файл и проверьте первые байты. Отключите вывод предупреждений в HTTP-ответ, удалите отладочные строки и BOM из PHP-файла, который выполняется до генерации. Логи при этом не выключайте — перенаправьте сообщения в журнал. Убедитесь, что ответ начинается либо с XML-декларации, либо с допустимого UTF-8 BOM непосредственно перед ней.
9. Короткий пример для PHP
Если контракт конкретного источника говорит, что он отдаёт Windows-1251, преобразование можно выполнить на входе:
function normalizeCp1251(string $value): string
{
    if (mb_check_encoding($value, 'UTF-8')) {
        return $value;
    }

    return mb_convert_encoding($value, 'UTF-8', 'Windows-1251');
}

$name = normalizeCp1251($sourceRow['name']);
mb_check_encoding() отвечает только на вопрос, является ли последовательность допустимой для указанной кодировки. Он не доказывает, что смысл текста не был испорчен раньше. А преобразование из Windows-1251 допустимо здесь потому, что кодировка источника известна по контракту.
Не прогоняйте каждую строку через mb_convert_encoding() «на всякий случай». Если данные уже UTF-8, повторная конвертация из другой кодировки испортит текст. Для XML также используйте XMLWriter, DOM или другую XML-библиотеку: она правильно экранирует текст и не смешивает кодировку с ручной сборкой тегов.
10. Кодировка и XML-спецсимволы — разные проблемы
Этот фрагмент может быть сохранён в безупречном UTF-8 и всё равно оставаться сломанным XML:
<name>Хлеб & молоко</name>Амперсанд начинает XML-сущность, поэтому его нужно экранировать:
<name>Хлеб & молоко</name>То же относится к знаку < внутри текста и к ошибкам структуры тегов. Если валидатор ругается на сущность, незакрытый элемент или вложенность, перекодировка файла это не исправит. Общий порядок проверки структуры, полей и ссылок есть в материале «Как проверить YML-фид: 10 частых ошибок и способы их исправить».
11. Короткий чек-лист
- XML-декларация соответствует реальной кодировке файла.
- Файл целиком читается как UTF-8 без повреждённых символов.
- Перед
<?xmlнет пробела, warning или другого вывода. - В цепочке нет случайного повторного перекодирования.
- После изменения файл снова проверен XML-парсером.
- Ошибка не является обычной XML-проблемой со спецсимволами или тегами.
Большинство проблем с кодировкой находятся не в самом YML, а на границе между базой, PHP, готовым файлом и площадкой: разные части цепочки по-разному интерпретируют одни и те же байты. Поэтому сначала определите фактическую кодировку скачанного файла, а уже потом что-либо конвертируйте.